SenseVoice 手机端 ASR 与 WhisperKit 对比
给 LoRa 文字对讲机配了个 iOS App:声音从 BLE 收上来,在手机上离线转成文字,再发回对讲机。识别引擎一开始用 WhisperKit(whisper-base),现在换成了 SenseVoice-Small。
iPhone 17 Pro Max,同一批 10 句音频,两个引擎各跑了一遍。
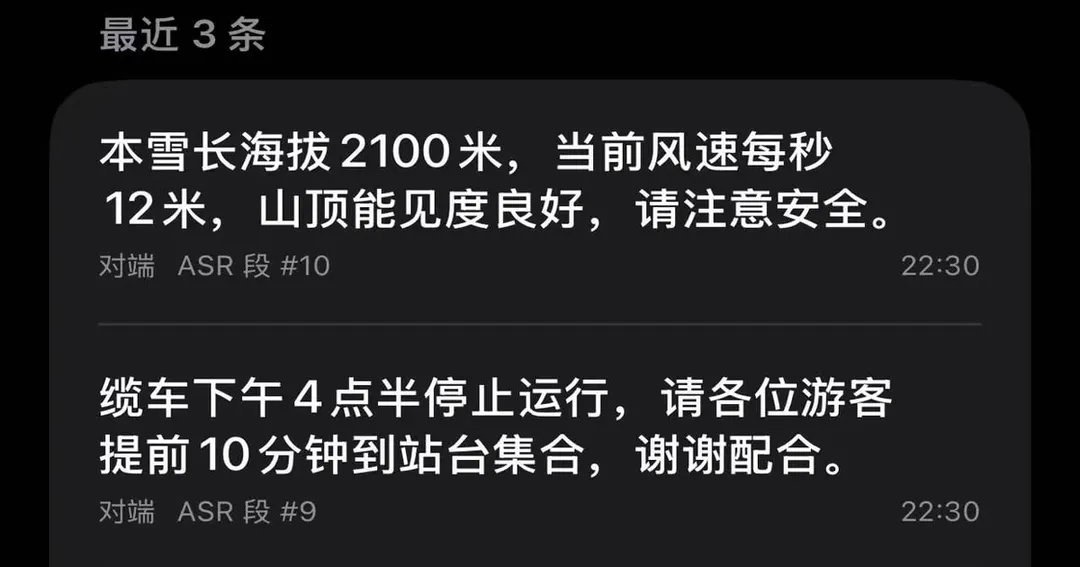
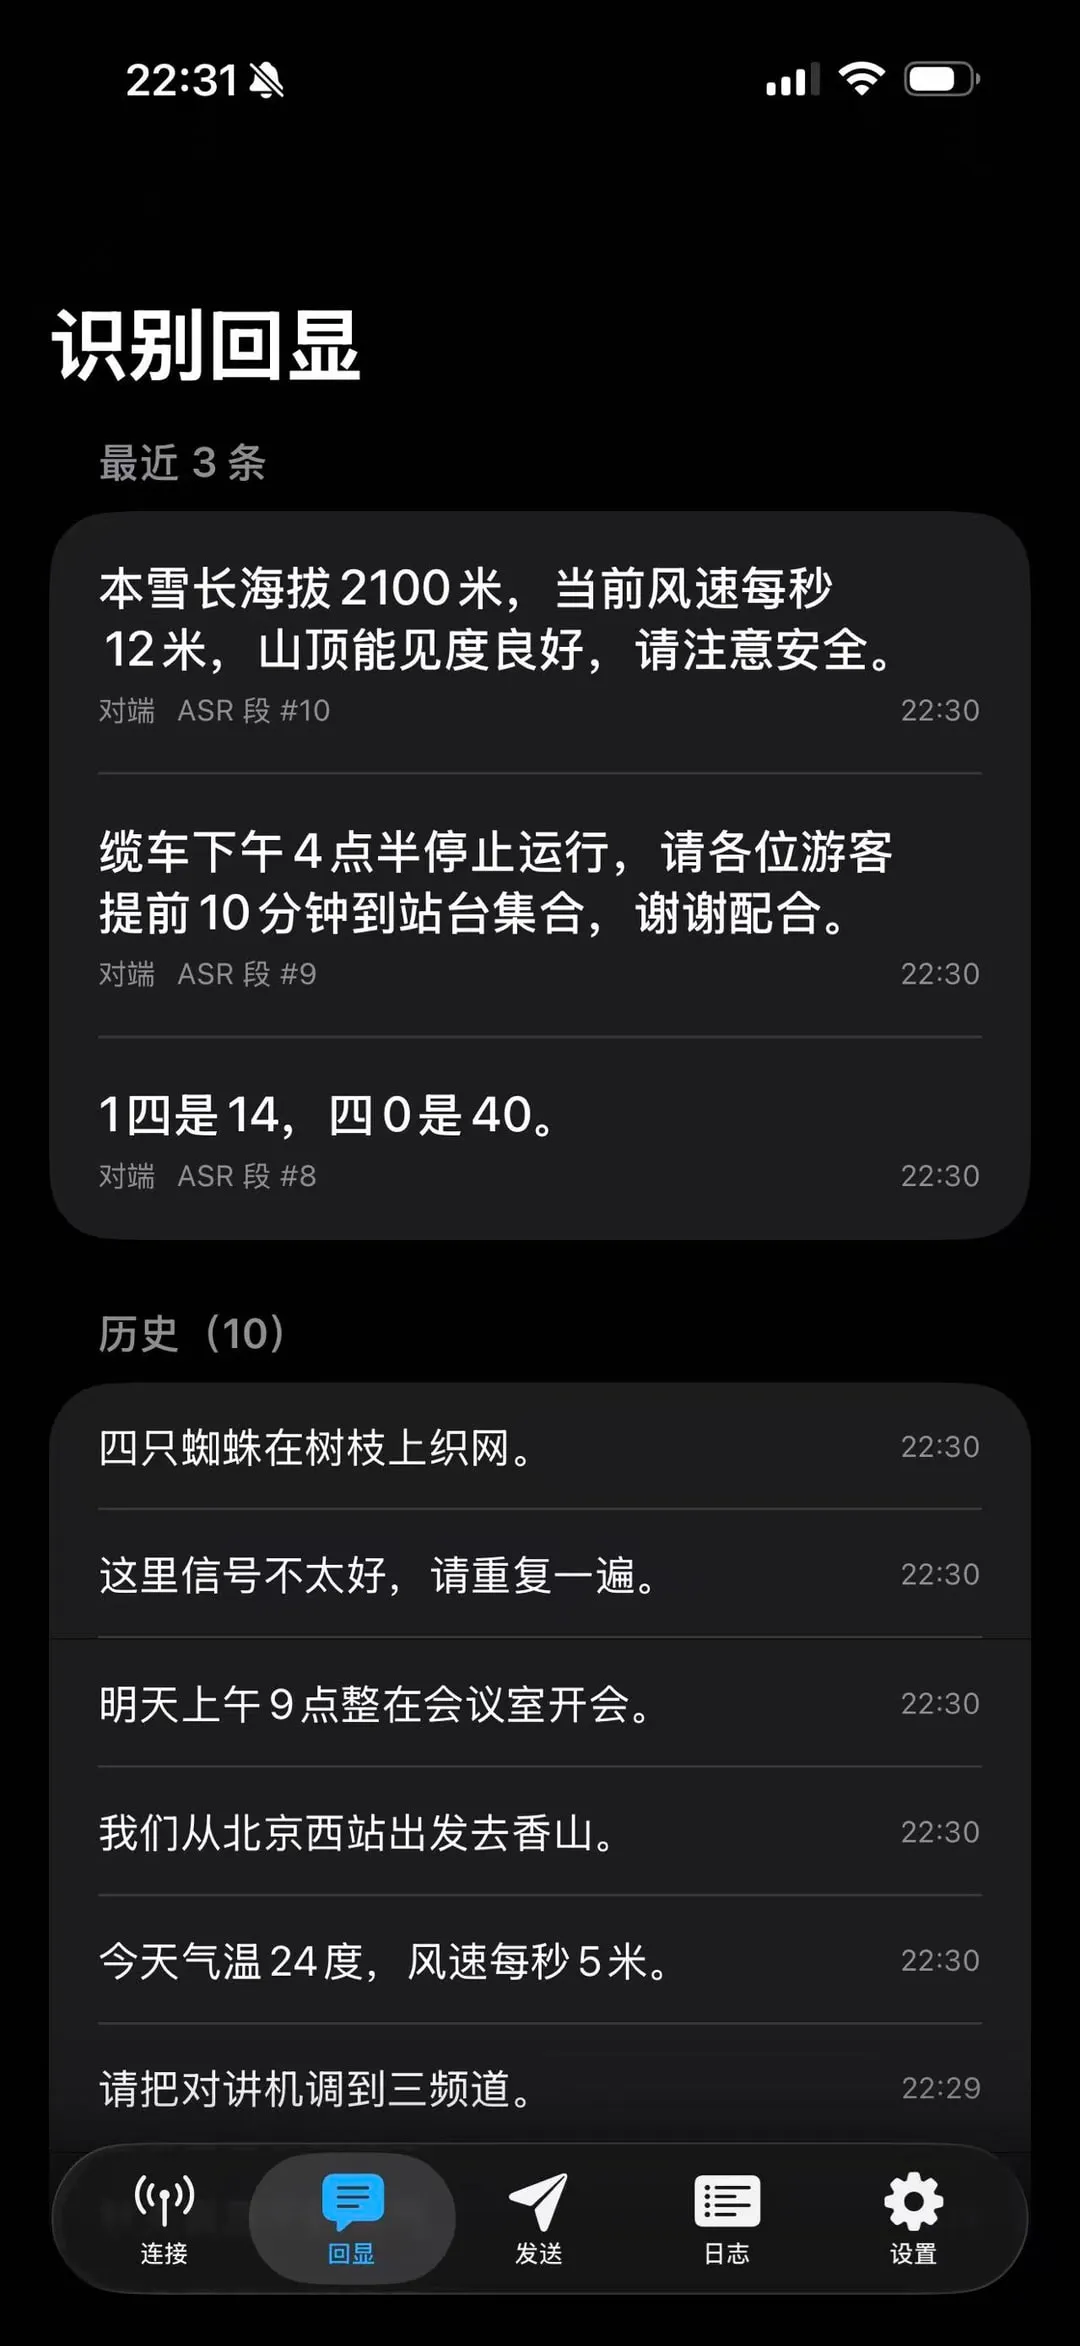
下面是 App 的识别回显页,最近三条就是这轮测试里的原话。
数据
| 口径 | WhisperKit base | SenseVoice int8 |
|---|---|---|
| 原样逐字 | 71.7% | 80.3% |
| 去标点 | 75.6% | 87.1% |
| 去标点 + 数字统一 | 80.1% | 95.9% |
| 模型加载 | 6378 ms | 301 ms |
| 单句中位耗时 | 92 ms | 48 ms |
逐句胜负:SenseVoice 胜 7 句,平 3 句,一句没输。
三个口径差这么多,是因为 SenseVoice 默认开了 ITN,会把「二十四度」直接写成 24度。只按「原样」口径比,等于在罚它把数字写对。
错在哪儿
挑几句最典型的。同一条音频,左边是参考,右边是 WhisperKit 写出来的:
| 参考 | WhisperKit |
|---|---|
| 请把对讲机调到三频道 | 请把对奖机调到三频道 |
| 我们从北京西站出发去香山 | 我们从北京西站出发去乡山 |
| 缆车下午四点半停止运行 | 拦车下午 4 点半停止运行 |
| 本雪场海拔两千一百米,当前风速每秒十二米 | 分学长海把两千一百米,当前封宿每秒十二米 |
错得很整齐,全是同音字。音是听对了的,字选错了。
这类错对文字对讲机尤其要命。满屏乱码你一眼就知道「识别失败了,再喊一遍」;同音字错出来还是通顺的中文,你可能顺着就读下去了。「缆车」变「拦车」还能猜,「本雪场海拔」变「分学长海把」就纯粹是编了。
最难的一句
「十四是十四,四十是四十」:
| 引擎 | 输出 |
|---|---|
| 参考 | 十四是十四,四十是四十 |
| WhisperKit | 14144144144 |
| SenseVoice | 1四是14,四0是40。 |
两个都翻车。中英数字混排是老大难,连纯中文数字都规整不利索。不过 SenseVoice 好歹留下了「是」和逗号,看得出原文的形状。
一个反直觉的点
SenseVoice 的模型更大:228 MB 对 144 MB,差不多 1.6 倍。但加载快了 21 倍,推理也快一倍。
差别在结构上。Whisper 是自回归的,一个字一个字往外吐,说得越多越慢;SenseVoice 不是自回归,一次前向出全部文本,耗时基本只跟音频多长有关。
推理快一倍我其实感觉不强——按一下说三秒话,等 100 ms 和等 50 ms 用户分不出来。但冷启动 6.4 秒对 0.3 秒是能感觉到的:App 刚点开那两秒,WhisperKit 还没醒,说的话就白说了。